8台DGX Spark拼出1TB内存,英伟达把桌面AI堆成了机房
英伟达 10 月 21 日在柏林 GTC 2026 上松了一条限制:DGX Spark 以前最多 4 台组集群,现在手动配置能连到 8 台。用 128GB 版本凑满,统一内存池能到 1TB。
单台 DGX Spark 是 4999 美元,约合 33450 元,64GB 统一内存,64GB 版本 10 月 23 日起通过合作伙伴陆续开卖。1TB 这个数字听着唬人,实际是 8 台机器各出 128GB 拼起来的池子,不是一块板子上焊了 1TB。
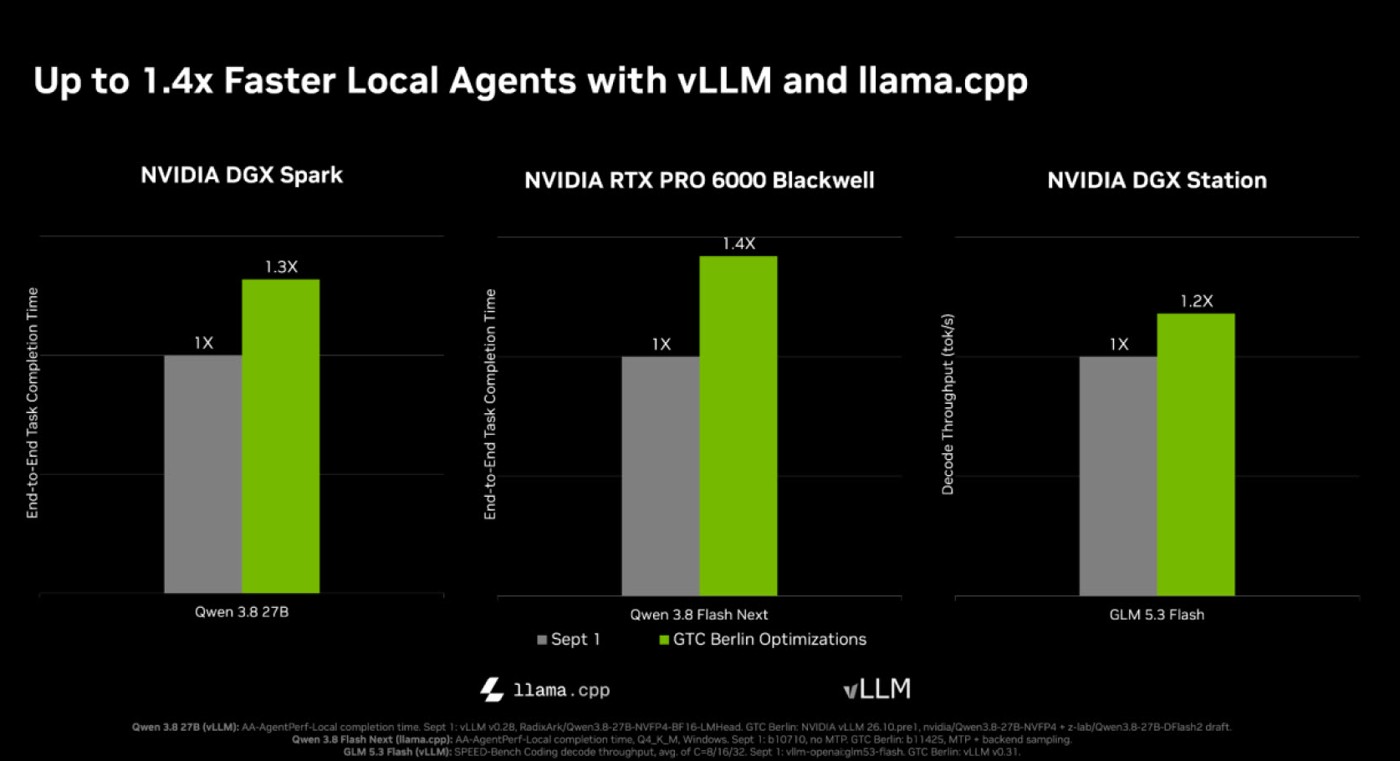
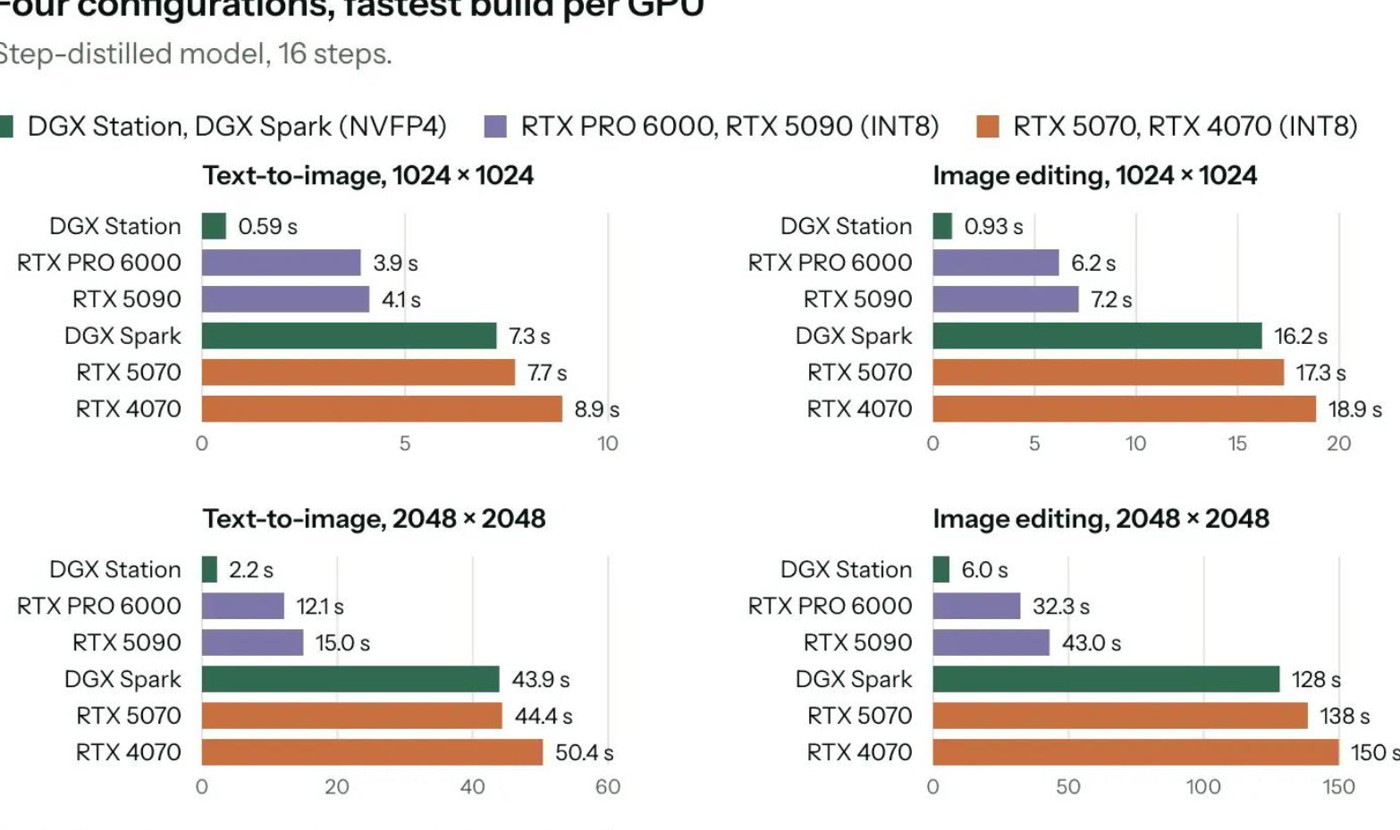
性能方面英伟达拉了 llama.cpp 和 vLLM 两个开源社区一起做优化。官方数字是 RTX PRO 6000 Blackwell 上端到端智能体任务最高快 1.4 倍,DGX Spark 快 1.3 倍,DGX Station 跑 GLM 5.3 Flash 时吞吐翻到 1.2 倍。换算成百分比就是 40%、30%、20%。
模型清单也扩了:Nemotron、GLM、DeepSeek、Qwen、MiniMax、FLUX.3 Klein 都能本地跑。还推了个叫 Recursive Flint 的编程模型,MoE 架构,总参 400 亿、激活 25 亿,在 64GB 的 RTX Spark 上推理超过每秒 220 个词元。另外给了几份 FP4 量化的检查点,Qwen3.8-Flash-Next-FP4-Local 单台 128GB 就能跑,GLM-5.3-Flash-FP4-Local 要两台。
说点不那么好听的。8 台桌面小机器堆在桌上,真正卡人的不是软件,是布线和环境:8 个电源、一台交换机、满桌的网线和散热风道。桌面级产品的功耗和噪音本来就不是按 24 小时满载设计的,跑大模型推理基本等于把它们当服务器用。互联带宽也是个隐性天花板,内存池到 1TB 了,跨机的 token 速度不会跟着线性涨。
英伟达还在把 DGX Station 往企业清单里塞,12 月出 Windows 版,管理侧加了 Intune、Splunk、Tanium 这些集成。个人开发者要不要跟?先算电价和噪音,再算那 4999 美元,最后问自己一句:本地跑大模型,到底是为了数据不出门,还是为了不用排队。
热门内容推荐

快捷栏目导航