英特尔把大模型调优塞进容器,老至强也能跑推理了
10月14日,英特尔推出了一套叫 Intel Inference Microservices 的东西,说人话就是给企业跑大模型推理用的容器化微服务。目标是让手里已经有至强处理器的公司,不用再花好几天手动调硬件参数,直接就能拿到调优过的推理能力。
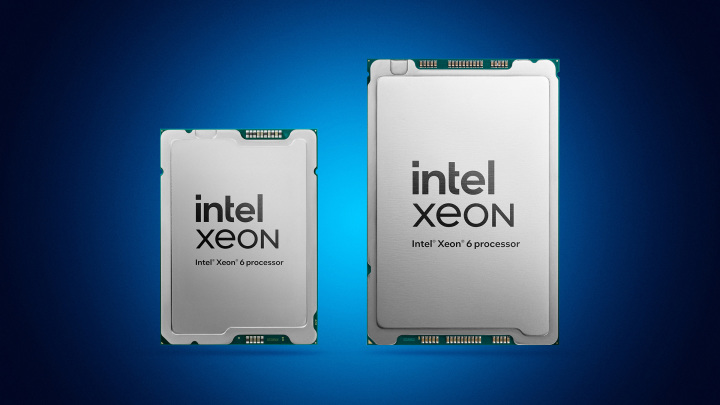
它怎么工作?每个微服务是一个独立容器,通过 OpenAI 兼容的 API 对外提供单个模型的服务。容器启动的时候会自动检测所在的至强型号,然后套用英特尔针对这颗芯片和这个模型预先验证好的配置。首批基于 vLLM 引擎,支持 BF16 精度,能在 Docker 或 Kubernetes 1.24 及以上环境跑,硬件要求是第四、五、六代至强,建议配 32GB 内存。
英特尔这段话点出了一个业内才懂的痛点:让大模型吐出一句回复不难,难的是在现有硬件上稳定、高质量地重复这件事。精度怎么设、计算任务怎么在核心间分配、内存怎么跨 NUMA 节点放、推理引擎用哪些指令集——这些都取决于模型和底层处理器。换个模型,对的参数就变了;换代芯片,又得重新调一遍。英特尔想做的,就是把这一整套调优封装进容器:用户只管选模型,容器负责选设置。
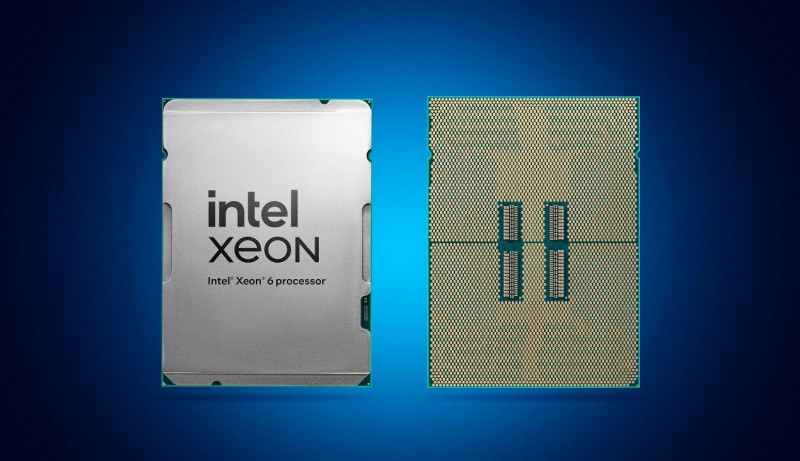
有个细节我觉得挺关键。容器启动时会检查处理器代数、分到的核心数、NUMA 节点数,还有处理器内置的加速器——比如做矩阵乘法的 AMX、做周边计算的 AVX-512、AVX2 和 VNNI。这些加速器其实早就焊在用户的芯片里了,但只有推理引擎知道它们存在、并且正确配置了,才能跑得动。很多人抱怨“我这至强跑大模型这么慢”,问题往往就出在这:硬件没被正确调用。还有个设计我挺认可——主机没被识别时,容器会直接报错,而不是默默用未调优的状态硬跑。
英特尔把它定位成“迈向硬件统一推理的第一步”,明说至强只是开始。以后扩展到自家 GPU(包括代号 Crescent Island 的数据中心推理 GPU),同一套微服务模式照搬,变的只是配置档案,应用面对的接口不变。翻译一下:今天基于至强搭的推理负载,以后迁到英特尔 GPU,改改部署配置就行,不用重写应用。这个“接口和芯片解耦”的思路,方向是对的。
但我得泼盆冷水。这套东西默认你企业里已经躺着一堆第四代以上的至强服务器。真掏钱买新服务器来跑私有推理的公司,多半会直接考虑 GPU 方案,因为大模型的吞吐和延迟,GPU 优势摆在那儿。英特尔这套更像在服务“预算有限、想先用手头硬件试水”的存量客户。这买卖能有多大,取决于有多少企业愿意在 CPU 上跑慢一点但便宜的推理——答案,可能要等它把这种东西铺到 GPU 上才揭晓。
热门内容推荐

快捷栏目导航