Agent 正在改掉云平台的算账方式:这拨负载不是人发出来的
一个工程师写完数据处理代码,点提交,然后去倒了杯咖啡。十几分钟甚至几十分钟后,他回到屏幕前看结果、改代码、再提交。这条「等待—反馈」的空隙,是数据平台过去默认的节奏。
Agent 没有这条空隙。它拿到一次结果,马上验证,接着并发去试第二种、第三种方案,快速拿到反馈,再发起下一轮。人用平台,交代的是一个相对确定的任务,算完、给结果、走人;Agent 用平台,会不停换着法子去够那个目标。压力就这么被放大了——管控的压力和隐形计算的压力,会十倍、百倍地往上翻。
这是 2026 年云计算要面对的一种新负载。模型长成 Agent 之后,它不再是一个躺着等你调用的接口,更像一个会自己找数据、自己拆任务、自己并发试错、一直跑下去的数字员工。它造出来的负载,和过去十几年云平台习惯承载的那种,是两回事。
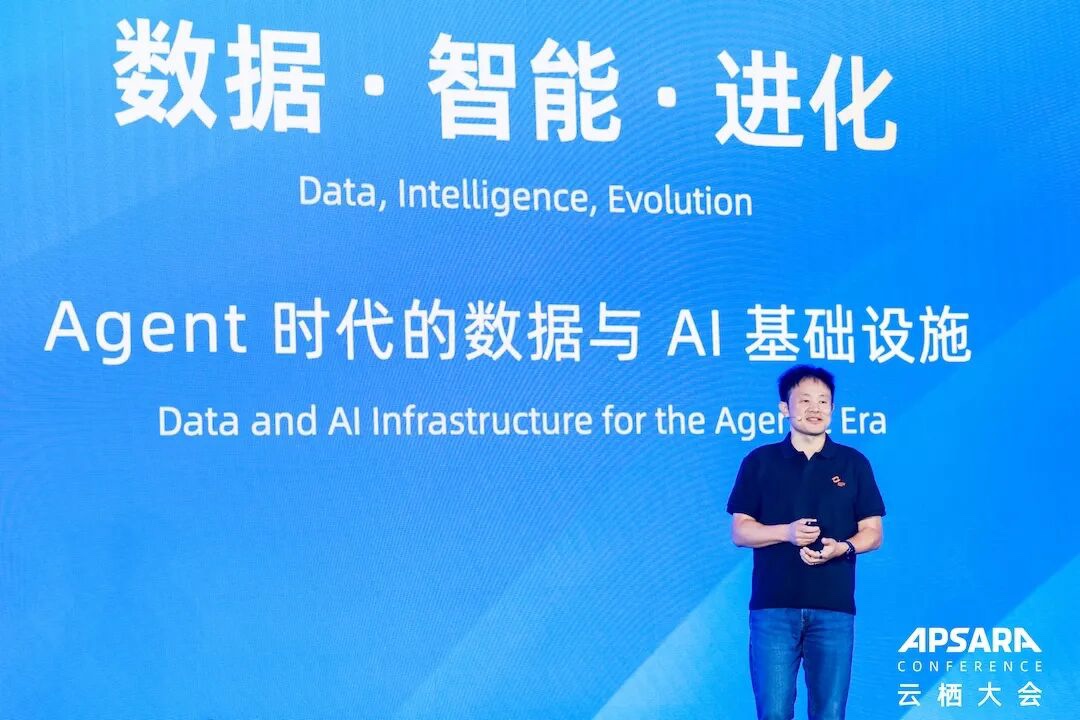
阿里云智能集团首席技术官李飞飞在云栖大会上把智能体落地拆成三个词:Model 决定智能的上限,Context 决定 Agent 读不读得懂你的业务,Harness 决定它能不能真正调起工具、把事做完、并且一直跑下去。想同时喂饱这三样,光把模型做大远远不够。
今年云栖大会上,阿里云沿着「从数据入湖、训练集生产、模型训练、推理服务,到系统自己优化自己」这条链路,一次性升级了一遍,并用「芯云模一体」把芯片、云平台与模型往协同设计上推。
数据端的麻烦更具体。过去的大模型主要处理文本和代码,自动驾驶、具身智能和科学计算面对的却是视频、点云、运动轨迹和传感信号。穹彻智能首席科学家吕峻提到,具身智能的数据以视频和点云为主,从采集完成到进入训练,中间可能经过几十道处理;一次数据版本迭代,短则两周,长则一个月。存储、数据处理和模型训练之间只要有一个环节衔接不畅,整个实验周期就会被拉长。
从长期看,具身智能可用的数据规模可能还有两到三个数量级的缺口。但吕峻认为,现阶段更直接的问题已经转向数据质量:哪些数据真正有效,怎么完成精细标注和前后质检,算法又能否把这些数据转化成模型能力。标注方式也在变——传统人工标注要组队、要培训,规则一改就重调流程;模型辅助标注迭代更快,人力可以集中到质检和高难度样本上。
参考来源:极客公园
热门内容推荐

快捷栏目导航