前沿模型同周登场:Gemini 4 与 MiniMax M3.1 各自押注了什么
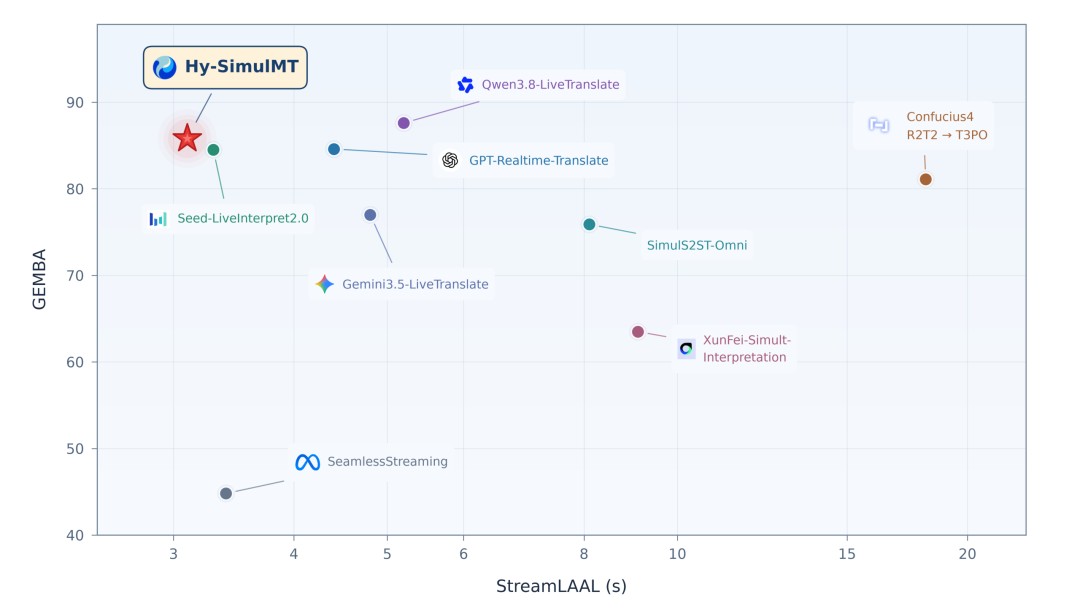
最近一波大模型更新颇为密集。谷歌正式发布了 Gemini 4,爱范儿的评测提到,这是“少见的写作能力强于代码能力”的前沿模型;与此同时,国内厂商 MiniMax 也更新到 M3.1,被拿来与另一款模型同题对照。两款模型几乎同周登场,恰好提供了一个观察“模型能力侧重”的角度。
Gemini 4:把写作推到前台
在很长一段时间里,衡量前沿模型的默认标尺是代码与数学。跑分榜、竞技场、基准测试,大多围绕推理与编程展开。Gemini 4 被讨论的特别之处在于,它在文本表达、结构组织与语气把握上展现出较强能力,反而让“写作”重新成为一个被认真对待的方向。评测中也保持了谨慎:跑分亮眼,不等于每一项实际任务都同样可靠。
MiniMax M3.1:在广度上做文章
MiniMax M3.1 的讨论更偏向“使用的广度”。在中文语境里,模型是否懂本地表达、是否贴合具体场景,往往比抽象的跑分更能决定体验。当多家模型在同一道题上交出相近答案时,差异就转移到了响应速度、成本、以及被集成进具体产品后的顺手程度。这也是国产模型近年来常见的发力点:不一定样样第一,但要在实际使用中“够用且好用”。
- 能力侧重:写作与表达、推理与代码,不同模型各有偏科。
- 成本与速度:单位调用的价格与延迟,直接影响产品化选择。
- 中文适配:本地表达与场景理解,是中文用户的直接感受点。
- 可集成性:能否稳定接入应用与工作流,决定落地效果。
模型竞争进入“分工”阶段
当模型数量足够多、能力足够接近时,竞争的重心会从“谁更强”转向“谁更适合什么”。有的用户需要长文写作的稳定输出,有的需要代码补全的低错误率,有的在意离线与隐私,有的只看成本。这种分化对用户其实是好事:选择的维度变多,也就不必再迷信单一的排行榜。
值得注意的是,评测者的态度普遍谨慎——跑分高不代表什么都行,实际体验才是最终裁判。模型更新以周为单位推进,而用户的耐心以月为单位消耗,谁能把“纸面能力”变成“日常可靠”,谁才会被真正留下。
热门内容推荐

快捷栏目导航