当 Agent 成为平台的主要用户:AI 正在重写数据基础设施
极客公园近期的一篇文章提出了一个有意思的观察:过去十几年,数据平台的默认节奏是「等待—反馈」。工程师写完一段处理代码,点下提交,然后去喝杯咖啡,十几分钟甚至几十分钟后回来,看结果、改代码、再提交。人类的工作被这个空档切成一段一段。

Agent 没有那个空档
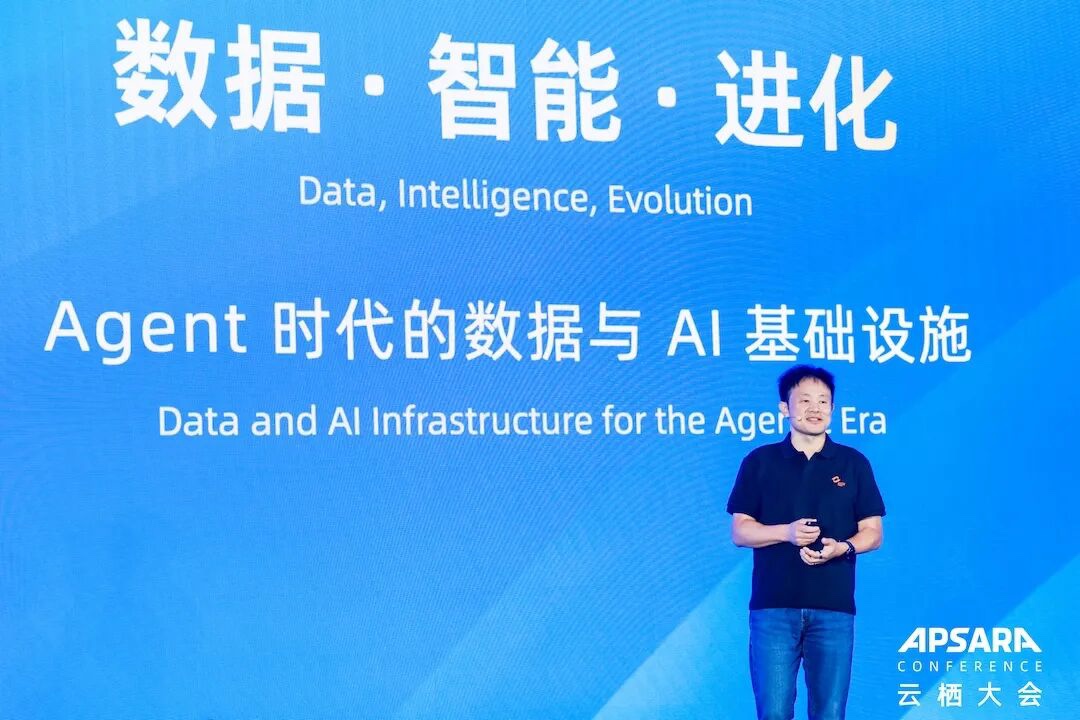
当使用平台的主体从人变成 Agent,节奏就变了。Agent 拿到一次结果,可以立刻验证;紧接着并发地去试第二种、第三种方案,飞快拿到反馈,再发起下一轮调用。它不会「去喝咖啡」,也不会因为等待而降低触发频率。于是,原本为人类操作设计的平台,开始显得跟不上。
- 调用密度不同:人一天可能提交几十次,Agent 可能在几分钟内完成同样量级。
- 试错方式不同:人会权衡后再行动,Agent 更倾向于穷举式地并行尝试。
- 反馈要求不同:人容忍几十秒的延迟,Agent 的循环对延迟高度敏感。
被重新审视的几个环节
如果 Agent 成为新的「重度用户」,基础设施里一些长期被忽视的环节就会被放大。
首先是调度与并发。为人类会话设计的排队与限流策略,面对高频、短周期、并发的调用时,可能既浪费资源又拖慢整体效率。其次是数据接口。很多内部工具只有图形界面,没有稳定的程序化接口,人类点几下就完成的事,Agent 却无从下手。再次是可观测性。人类能凭经验判断「这个结果有点怪」,Agent 需要的则是清晰的日志、指标与校验规则。
成本与可靠性仍是主线
热度之下,也要看到现实的阻力。Agent 的高频试错意味着更高的算力与存储开销,如果每一次失败都等价于一次真金白银的调用,成本会迅速累积。可靠性的问题同样突出:一个偶尔出错的自动化流程,交给人工复核还可以补救;当它被放在数据链路的关键位置,错误就可能被放大。
因此,业界的分歧在于「把 Agent 放到多深的位置」。乐观者认为它应当深度参与数据管道,成为默认的执行者;谨慎者则主张先把它限制在辅助角色,保留人工确认的关卡。两种立场并不完全对立——在多数实践里,边界是随着可靠性提升而逐渐外扩的。
一个更朴素的判断
与其争论 Agent 会不会「重写」基础设施,不如看它有没有改变真实的工作方式。当越来越多的人开始用一句话交代任务、让系统自己去跑循环,那些为「人点鼠标」而设计的假设就会一层层被替换掉。这个过程可能不会轰轰烈烈,更可能是某天突然发现:某个环节已经很久没有人工介入了。
热门内容推荐

快捷栏目导航