日均 175 万亿个词元,推理真的比训练更值钱了吗
IT之家 11 月 1 日转的央视新闻报道,工信部赛迪研究院(中国电子信息产业发展研究院)发布的《新域新质创新发展十大趋势》里有几组数字:我国人工智能推理数据量首次超过训练数据量;截至 2026 年 6 月,日均词元调用量超过 175 万亿,比 2024 年年初增长 1000 多倍;顶尖大模型的迭代周期从几个月压缩到几周甚至几天。
175 万亿这个量级,换个算法更好懂。假设一次调用平均消耗 500 个词元,175 万亿就是每天 3500 亿次调用;分到工信部口径的 7 亿生成式 AI 用户头上,人均每天 500 次。这个数明显偏高,说明调用的大头不在个人,而在企业和应用侧——客服、检索、代码补全、内容审核这些机器对机器的场景。
报告里配套的产业数据也对得上:已累计建成 500 多家卓越级智能工厂,覆盖 31 个省区市,涵盖超过 80% 的制造业行业大类;国产算力和大模型在钢铁、汽车等 20 个行业落地 1000 多个应用场景。截至 2026 年上半年,我国生成式人工智能用户超 7 亿,普及率突破 50%(这组数字来自 CNNIC 今年 9 月发布的《生成式人工智能应用发展报告(2026)》)。
推理超过训练,产业上的含义是钱的位置变了。训练是一次性的资本开支,几万张卡堆在一个机房,跑几个月,结束就结束。推理是运营开支,按调用量付费,跑得越多花得越多。前者养的是英伟达和云厂商,后者养的是电力公司、推理芯片厂和做中间层的服务商。
算一下电费。175 万亿词元,按现在主流模型的能效水平,每百万词元大概消耗 0.3 到 1 度电(取决于是不是 MoE、上下文多长、batch 多大),一天就是 50 万到 175 万度。按工业电价 0.6 元算,一天 30 万到 105 万元,一年 1.1 亿到 3.8 亿元。这个数字放在全国用电量里微不足道,但对单个服务商来说是实打实的成本项。
所以"推理为王"这句话只说了一半。真正决定生意好不好做的,是每百万词元的售价能不能覆盖电费加折旧。今年国内大模型 API 的价格战打到什么程度?主流模型百万词元输入报价已经降到个位数人民币,部分厂商直接免费送额度。175 万亿的调用量里,有多少是付费的,报告没说。这个缺口才是行业最真实的处境。
智能工厂那部分倒是实的。500 多家卓越级智能工厂,覆盖 80% 的制造业大类,这个渗透率比大部分人想的高。钢铁行业的质量检测、汽车行业的焊装质检、电子行业的 AOI 复判,这些场景用视觉模型替人眼,投入回收周期通常在 18 个月以内,是少数算得过来账的 AI 应用。
至于迭代周期从几个月压到几周,那是头部几家的事。国内能保持这个节奏的团队不超过 5 个,剩下的都在做微调和行业适配。词元调用量涨 1000 倍这件事,2024 年年初的基数太小是主要原因——那时候很多公司的日调用量还在百万级,工信部这次的统计口径也换了,跟去年的数不能直接比。用一个低基数算出来的千倍增长,别太当真。
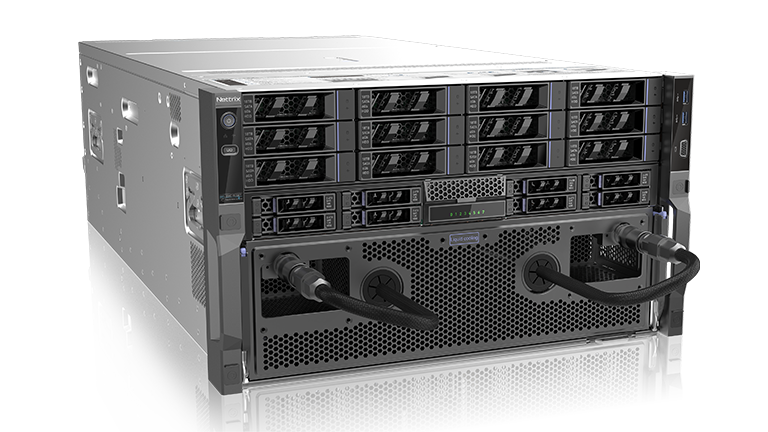
推理和训练这笔账的另一头在硬件上,8 台 DGX Spark 拼出 1TB 内存那种玩法,本质是把训练侧的门槛搬到桌面上,跟推理侧的规模化不是一回事。
热门内容推荐

快捷栏目导航
相关内容推荐