智元 GO-3 让机器人在便利店自己学会了干活,成功率从 28.6% 爬到 85.7%
10 月 29 日,智元发布了具身模型 GO-3 Preview。IT之家 10 月 30 日的报道列了几个数字:预训练、后训练、部署后三个环节打通,叫"全链路规模化学习";架构叫 WRAM(World Reasoning Action Model),把任务推理、未来预测、动作生成连在一起;登顶 RoboDojo、RoboTwin、RoboColiseum 三个评测榜;2026 年底全面开源。
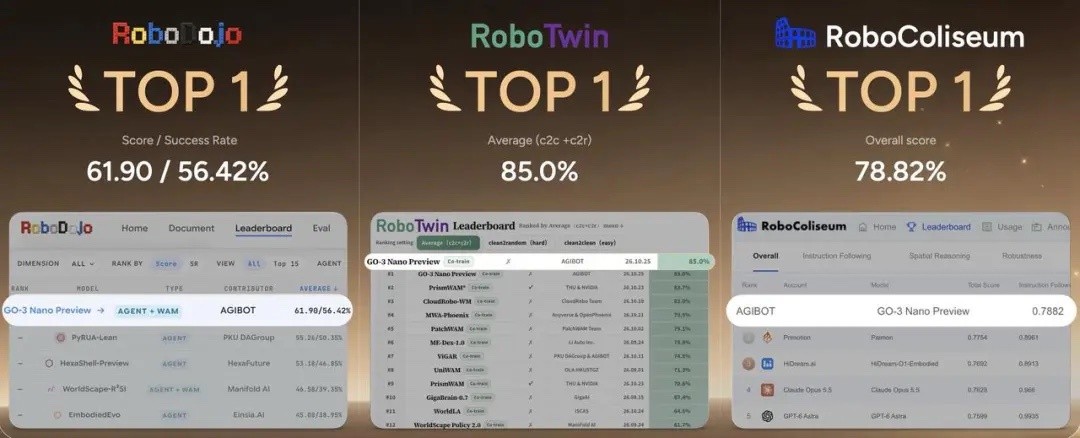
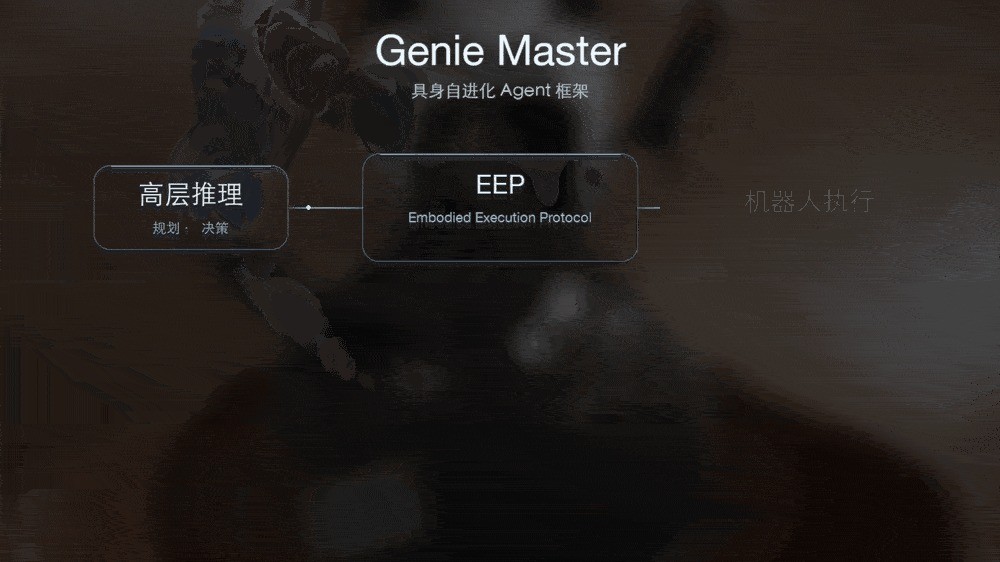
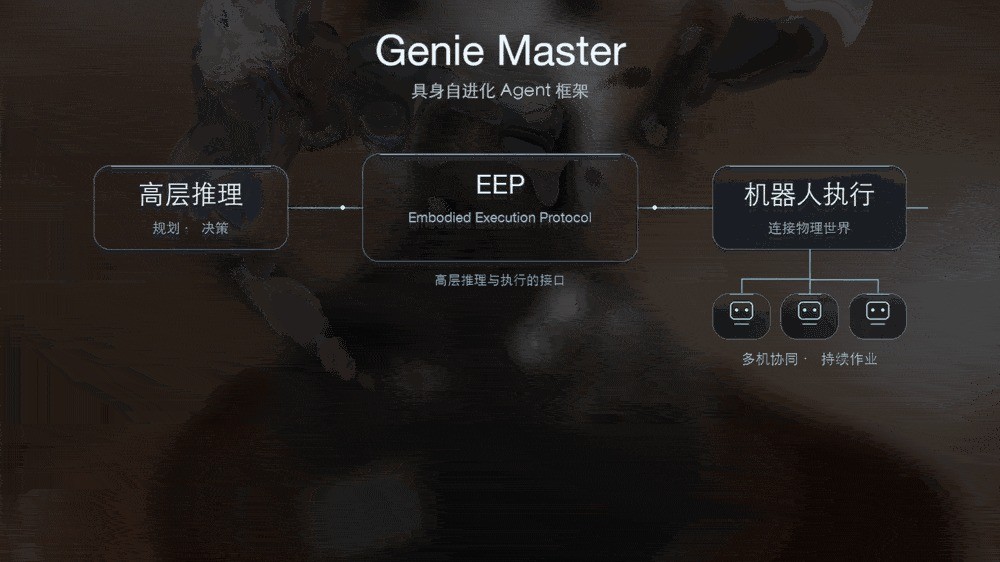
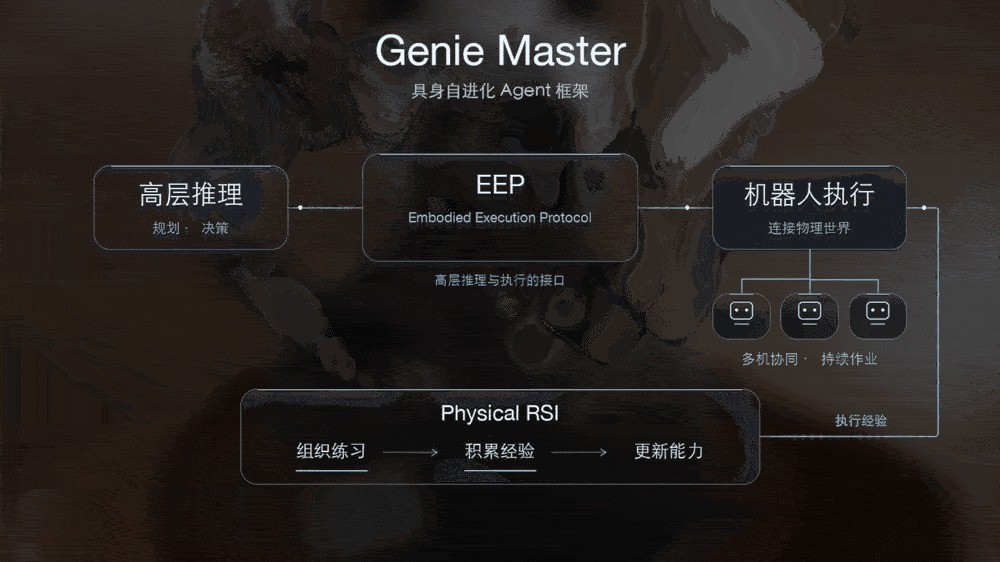
榜单第一这种事,看过太多。真正让我停下来的是另一组数字:搭载 Genie Master 框架的精灵 G2 在真实便利店上岗,完整任务流程的成功率从首日 28.6%,五天后稳定到 85.7%。不依赖人工示范,不依赖重新调试,自己定位失败原因、调整策略、沉淀经验。单任务成功率比常规 SFT 微调高 17.7 个百分点。
28.6% 到 85.7%,这个跨度在真实环境里很少见。实验室里的机器人成功率动辄 95%,一到真实场景就掉到个位数——光照变了、物体位置偏了、地上有水、旁边有人走动,任何一个变量都能让模型失效。
为什么真实便利店这么难。SKU 数量是一道坎,一家 100 平米的便利店大概有 2000 到 3000 个 SKU,包装形状、软硬、反光程度全不一样。货架间距窄,机械臂伸展和避障的空间有限。最麻烦的是任务链条长:走过去、拿起来、扫码、放到袋子里,中间任何一步失败,整个任务就算失败。
常规做法是采集数据、训练、部署、发现问题、再采数据、再训练,一套流程下来几周。智元说的"部署后学习",是把最后这一步接上——机器人在现场自己试错,把失败的记录变成动作指南。这一步省掉的,是工程师飞一趟现场、重新采数据、重新训练、重新部署的两三周。
报道里举了个具体例子:挂小挂钩。这个动作人做起来不用想,机器人得先判断钩子的朝向、手指的进给角度、用多大力。失败几次之后它自己找到了动作时序,把这件事学会了。挂一个钩子人类大概 3 秒,机器人第一次尝试用了 40 多秒,到第五天掉进 15 秒以内。
数字上更直观的是另外两个实验:桌面冰壶,经过 4 小时在线迭代,性能超过被测人类的平均水平;抽积木塔,能连续抽 5 块还保持塔身稳定。抽积木塔这个任务对力控精度的要求极高,抽错一块整个塔就塌,容错率接近零。
WRAM 这个架构名字听着抽象,拆开看是三件事:任务推理负责"要干什么",未来预测负责"做了会怎样",动作生成负责"怎么动"。传统 VLA(视觉-语言-动作)模型基本是"看到画面+听到指令→直接输出动作",中间缺了"预判"这一环。加了世界模型之后,机器人可以先在内部推演几帧,再决定动作,这一点对长程精细任务(比如做煎饼果子、拼乐高)是必需的。
数据这块,智元说的是"异构经验共同学习":人类第一视角视频提供物体交互和任务过程的样本,机器人轨迹建立观测、动作与物理结果之间的对应。前者一天能采到上万小时,后者一百台机器一天也就几百小时,量差两个数量级,动作空间还对不齐。把两类拼在一起训练,是这两年具身智能的主流思路:斯坦福 2023 年牵头的 Open X-Embodiment 汇总了 22 种机器人、100 万条轨迹,谷歌的 RT-X 走的是同一条路。
后训练用的是分布式混合环境系统 Genie Evolver,依托百台真机加物理仿真加世界模型。百台真机是个硬门槛——大部分做具身智能的公司,真机数量在 5 到 30 台之间,一百台意味着同样的 24 小时里能产出的真实轨迹是别人的 3 到 20 倍。真机单价按 20 万算,一百台就是 2000 万元的固定资产,还得配场地、供电和运维。
算一笔账,看这条路走不走得通。一台精灵 G2 这类人形/轮式双臂机器人的整机成本,按行业公开口径在 20 万到 40 万元之间,取中间值 30 万元。便利店一个夜班店员,月薪按 6000 元算,一年 7.2 万,加上社保公积金按 9 万。一台机器人 30 万,摊三年折旧每年 10 万,加上维护、电费、远程运维,每年成本大概 13 万。
也就是说,机器人的年成本比一个店员贵 4 万左右。而且 85.7% 的成功率意味着每七个任务要失败一次,便利店里失败的代价是掉货、错单、顾客等待。真要替代人力,成功率得推到 99% 以上,同时成本要压到 8 万一年以内。
所以智元现在讲的不是替代,是"补位"。便利店最难招的是夜班,人不愿意上,机器人愿意。这个场景的商业逻辑成立,但规模起不来——全国 24 小时便利店大概 30 万家,按一台 30 万元、三年回本算,每年要省下 10 万元人力,也就是一个半以上员工的工资,能对上这个账的门店不到 5%。
开源这件事倒是值得单独说一句。2026 年底全面开源,意味着权重和代码都会放出来。智元在赌生态——谁先把开发者和场景方拉到自己这套架构上,谁就定义标准。这条路宇树在硬件上走过,DeepSeek 在大模型上走过。腾讯上个月开源同传模型走的是同一条路,把权重放出来换生态,国内做大模型的现在都学会了这一手。
发布稿最后有一句话挺实在:有了通用能力,并不意味着机器人就能直接胜任所有复杂任务,就像人学会基本动作后仍需反复练习。这句话是整篇稿子里唯一没有修辞的表述,也是这个行业现在的真实状态。
热门内容推荐

快捷栏目导航
相关内容推荐