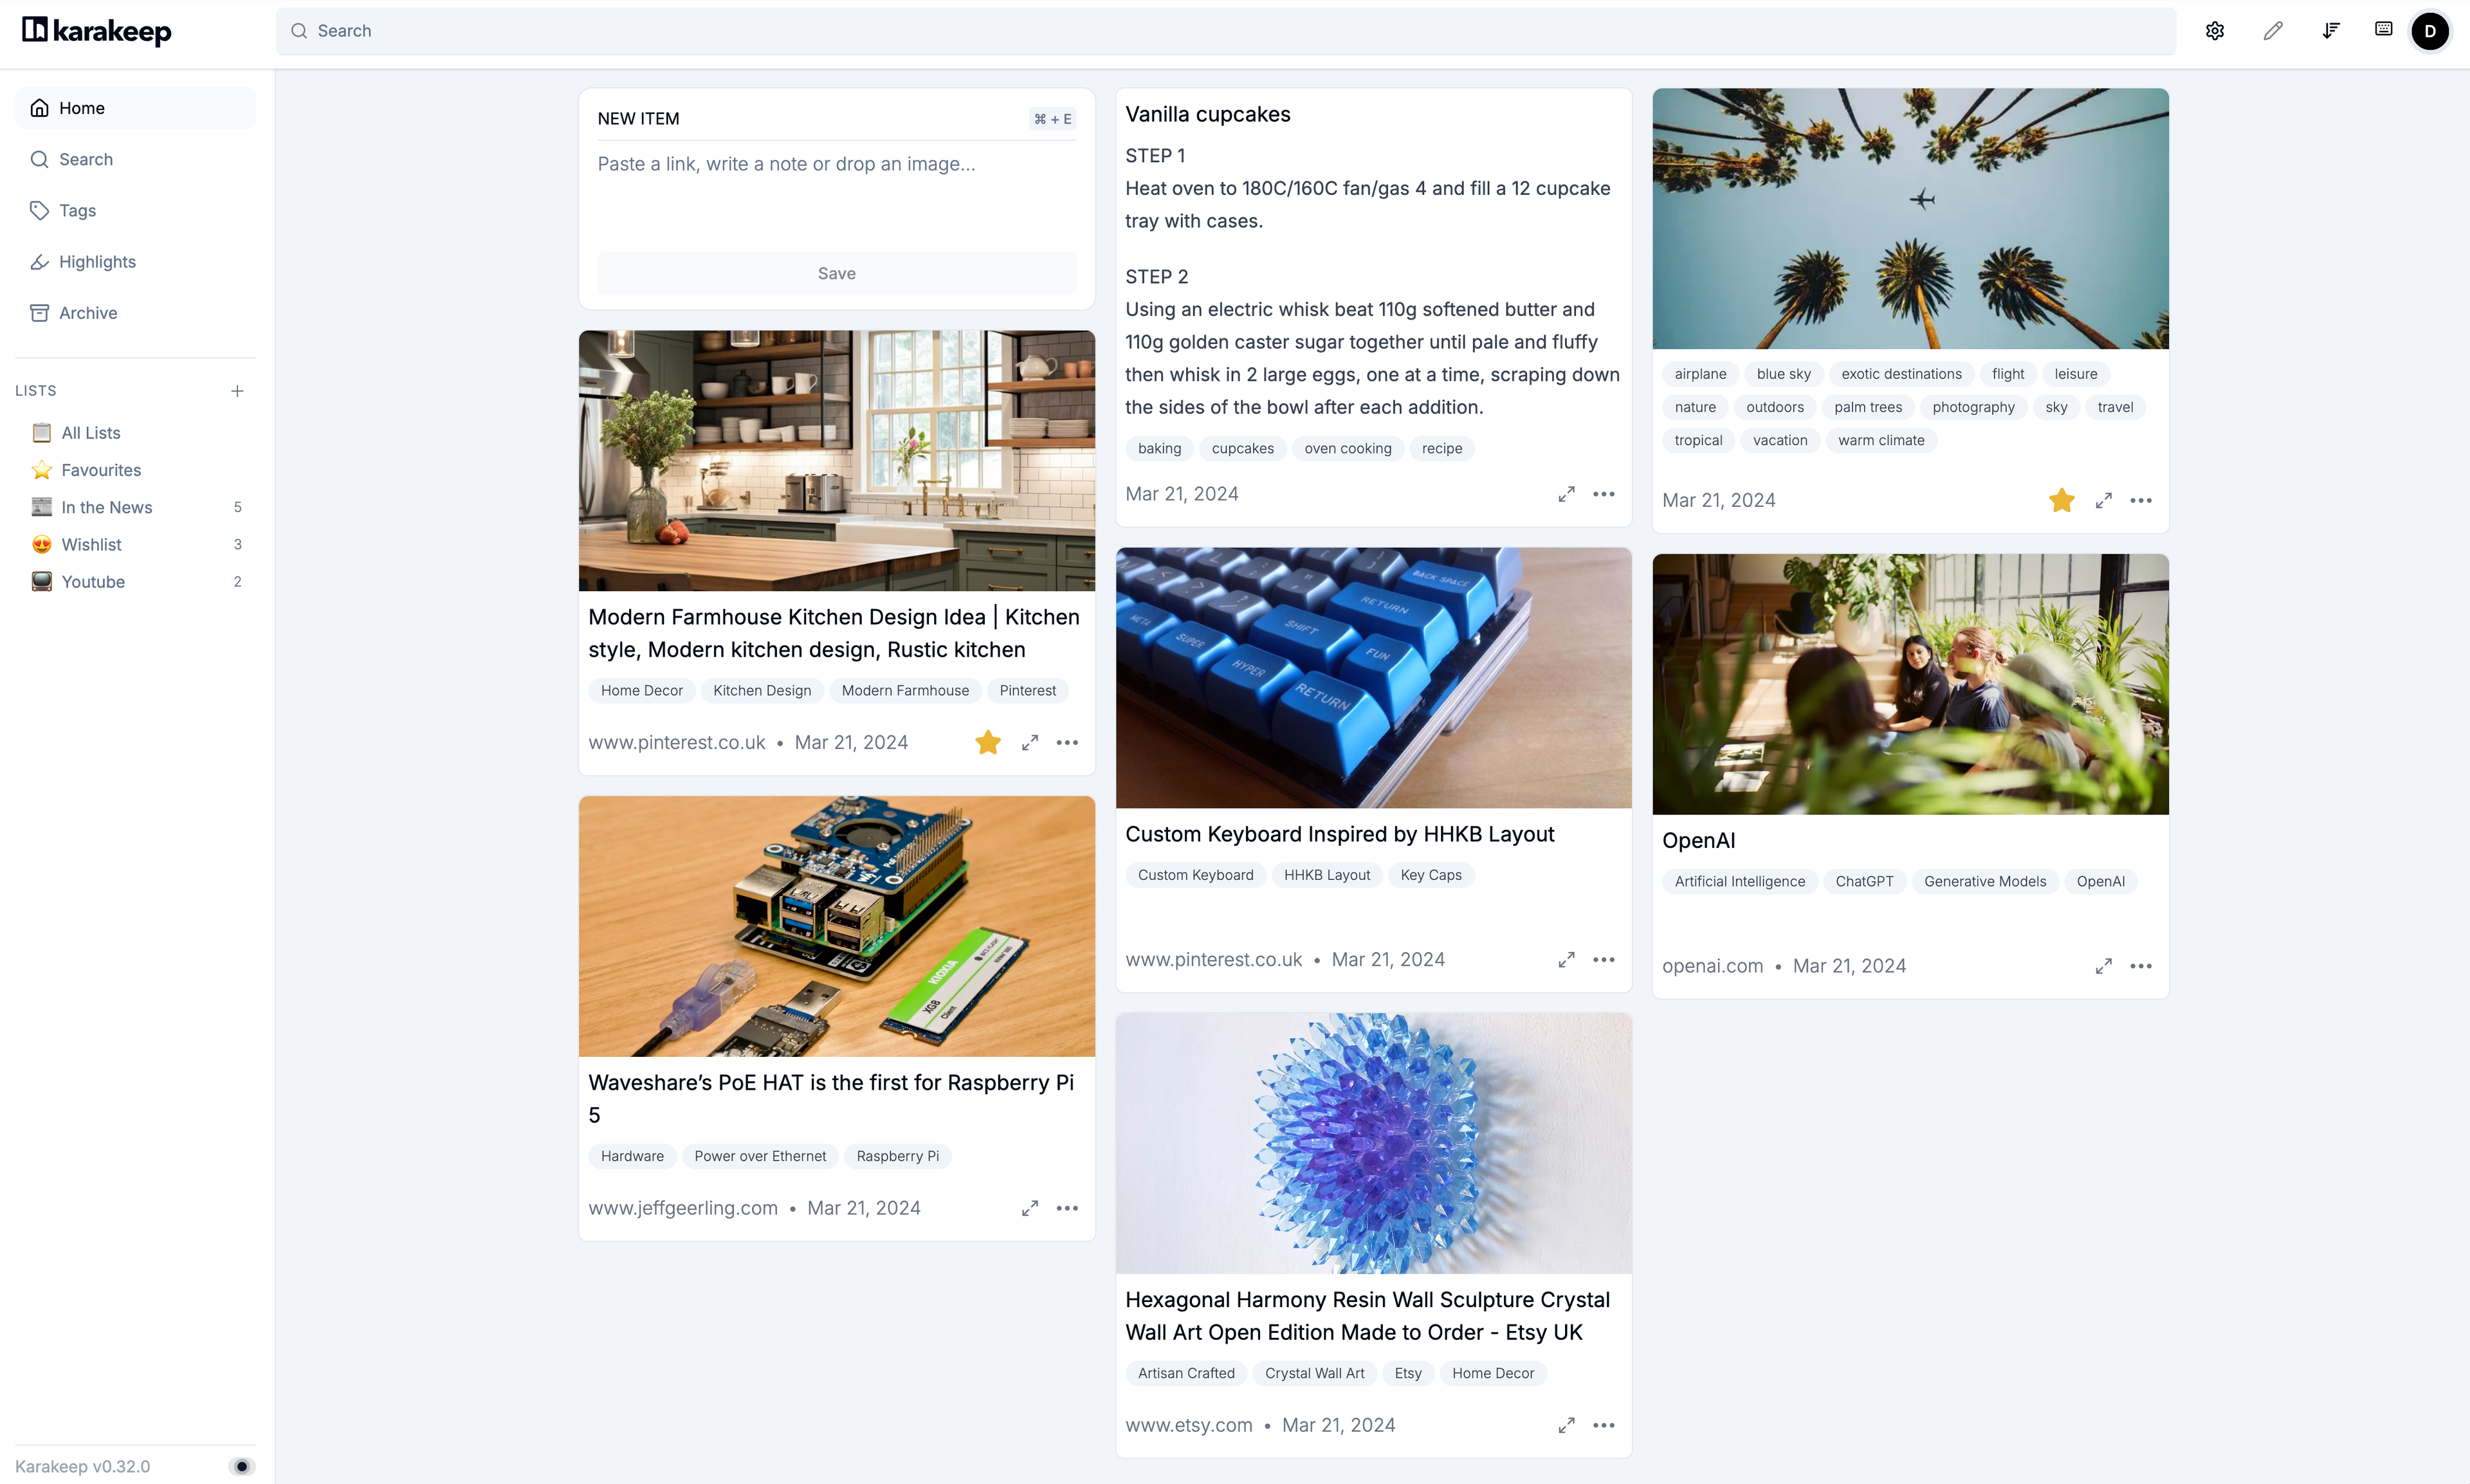
Karakeep在10月18日发了0.34.0,GitHub上已经接近2.97万星。这工具以前叫Hoarder,干的事很朴素:把网页、笔记、图片、PDF存到自己的服务器上,加标签、加摘要、全文搜索。自托管,数据在自己手里。
这次更新最实在的一条是抓取。它把浏览器自动化从Playwright换成了Patchright,并且开始用完整的Google Chrome,不再是无头精简版。效果是Cloudflare那类验证页不再被当成正文存下来——以前你收藏一个站点,回来看发现存下来的是一整页"Checking your browser"。
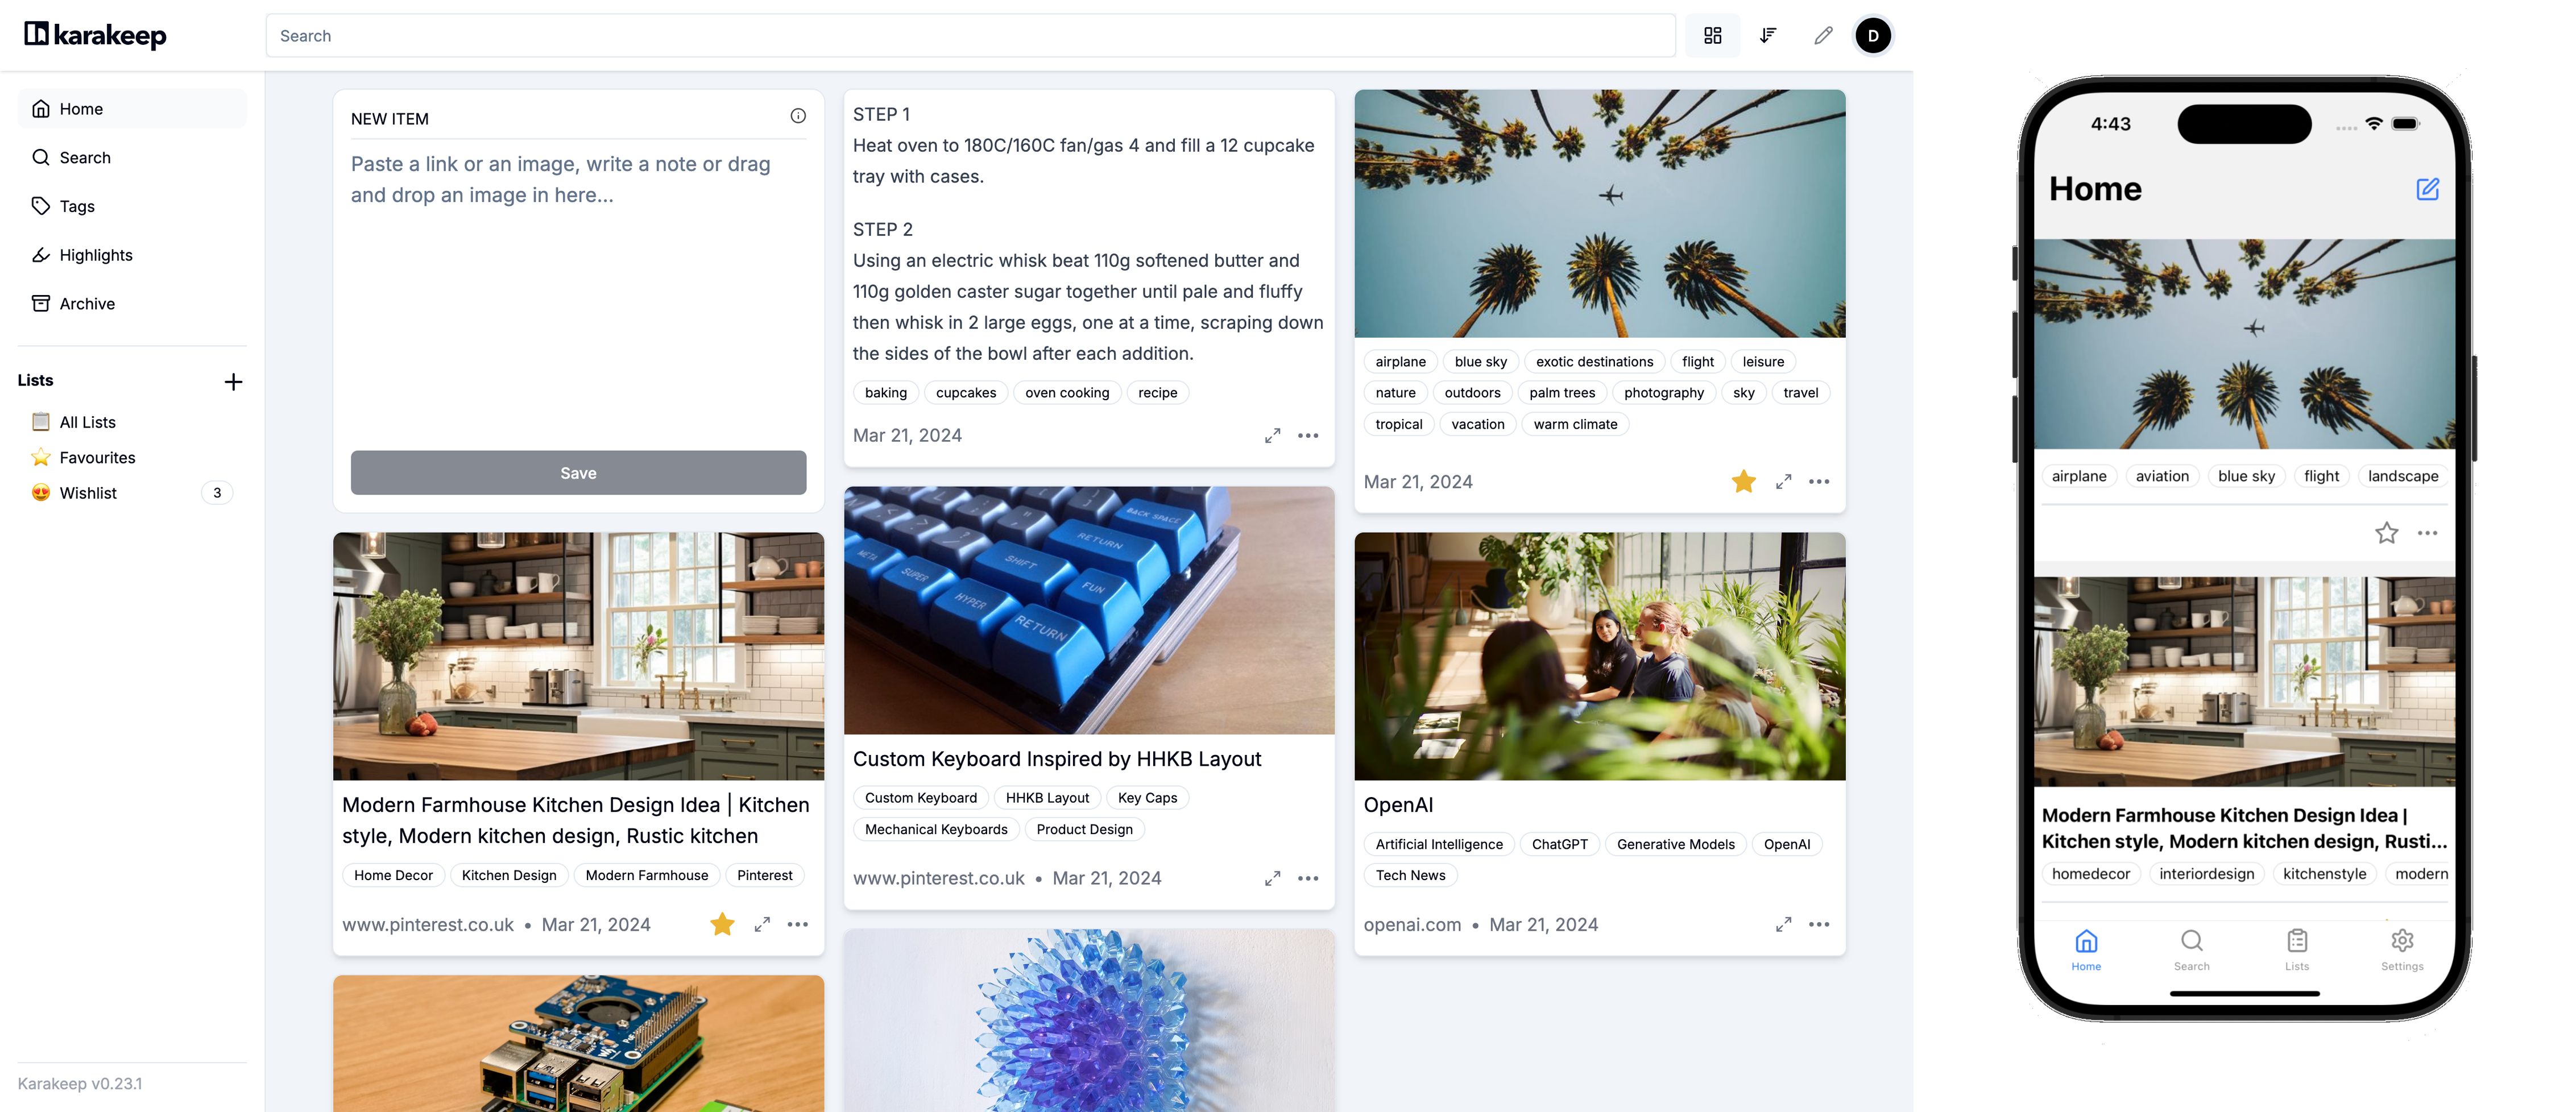
第二个变化是离线。移动端加了自动离线下载,打开App就把最近收藏的网页拉到本地;还能指定某个列表整个下下来。这个功能对通勤党有用——地铁里没信号,收藏了一堆文章一篇都打不开,这体验挺蠢的。
第三个是内存。官方修了一个查询缓存导致的内存泄漏,改成按需加载组件,官方说大多数部署环境常驻内存能少40MB左右。40MB听着不多,但这东西是长期跑在NAS或小主机上的,能省一点是一点。
还有些零碎的:新增Preserve Video,用yt-dlp手动下载指定书签里的视频,配合关掉自动下载,只存真正想留的;网页图片自动转WebP;搜索支持has:notes和has:highlights,能筛出带笔记或高亮的条目;MCP Server升级到新版SDK,CLI里内置了Agent Skill。
升级有个坑得提前说:身份认证从NextAuth迁到了Better Auth,升级后网页端所有用户都要重新登录一次。另外数据库里如果有仅邮箱大小写不同的账户,得先处理,否则可能登不进去。
我用这类工具最大的感受不是抓不到,是抓了不看。Karakeep的作者自己在文章里也承认,装了一年,用得不多,"只往里装,没怎么用"。这话挺诚实。不过它现在有个新用途:API完整,MCP也支持,可以当AI的资料库——自己不看,让Agent去看。