10 月 17 日,DeepSeek 把 V4.1 Flash 更新到了 V4.1-Flash-1017。网页端、App、API 一起换,调用方式没变,还是 deepseek-flash 这个模型名,价格也没动。
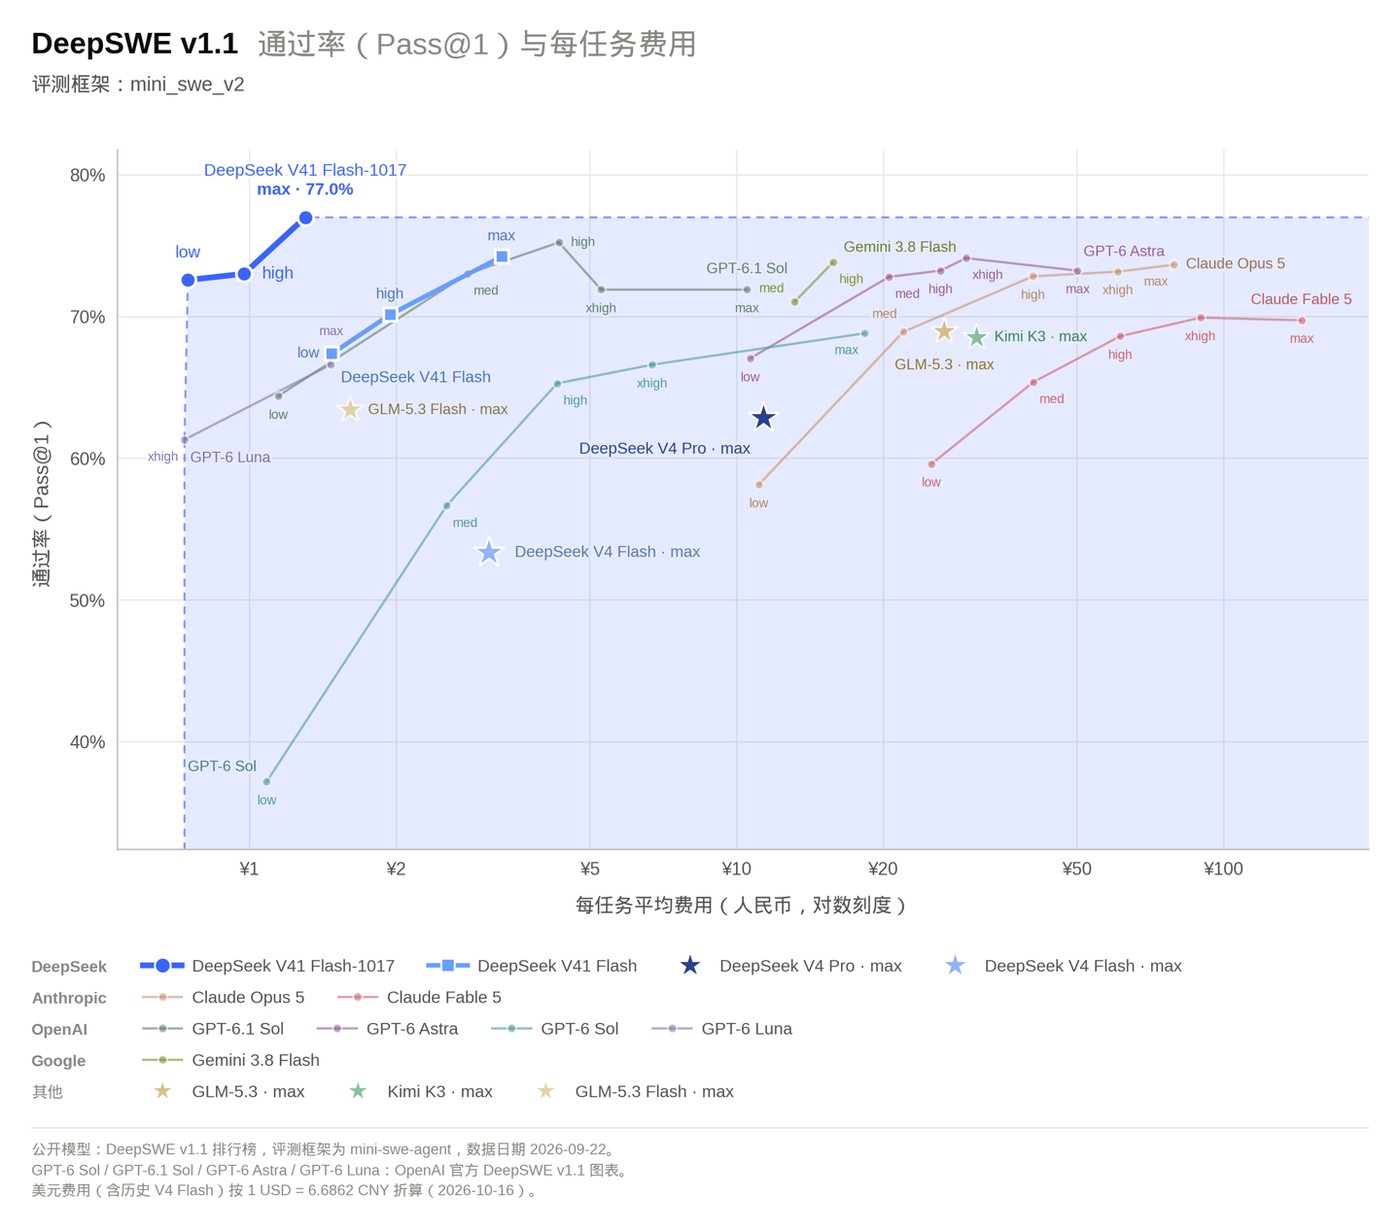
官方这次的说法挺技术:在性能和成本之间做“帕累托改进”。翻成大白话就是,能力涨了,但跑完一个任务花的时间和吐出来的字都少了,所以单次调用更便宜。
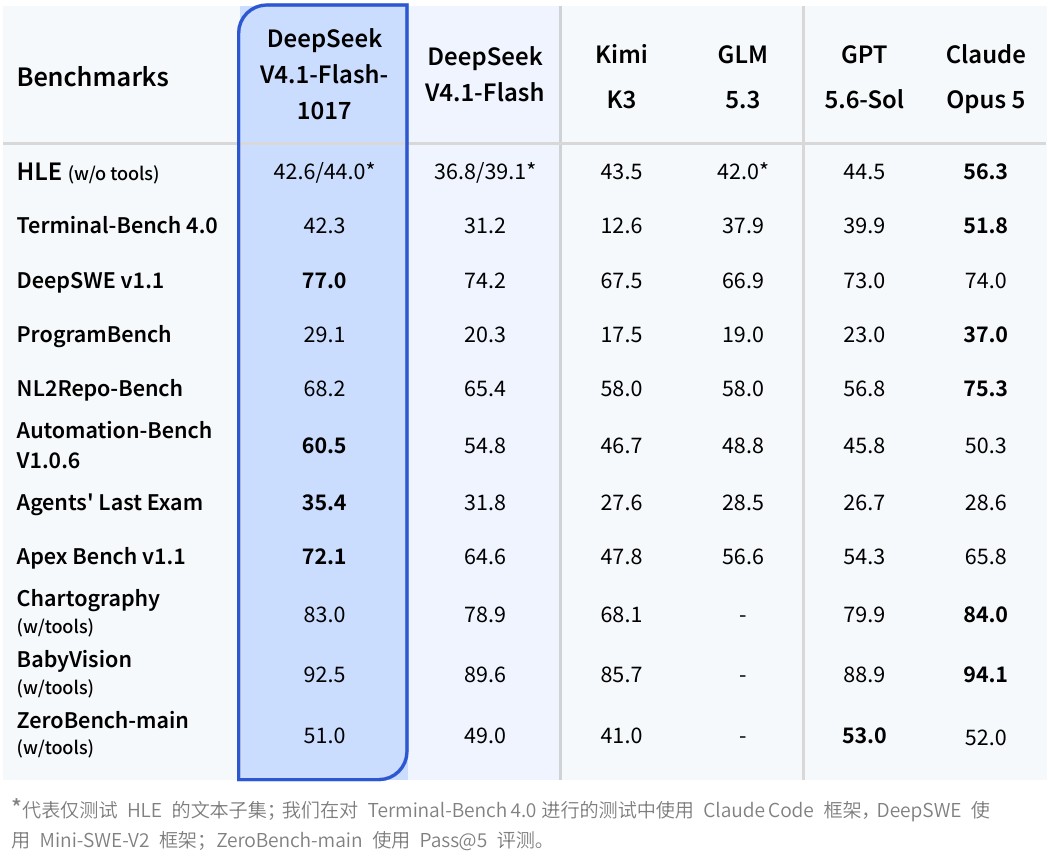
跑分给了一串:HLE 无工具 42.6,Terminal-Bench 4.0 是 42.3,DeepSWE v1.1 77.0,NL2Repo-Bench 68.2,Apex Bench v1.1 72.1,带工具的 Chartography 83.0、BabyVision 92.5。这些榜我不是每个都熟,但 Terminal-Bench 和 DeepSWE 这两个偏工程实操的分数,42 和 77 放在开源模型里算能打的。
真正值得琢磨的是“输出长度缩短”这一句。大模型的账单是按 token 算的,输出 token 通常比输入贵好几倍。模型如果学会了少废话、直接给代码,用户的实际花费会明显下降。快科技那边测算的说法是 1 美元能跑 13 亿 token,这个数字大概率是在特定场景、特定缓存命中率下算出来的,别当成日常价,但方向是对的。
这次还提了一个能力:从零构建完整项目。官方叫“许愿式”编程,意思是提示词和素材都很少的情况下,直接生成能跑的东西,覆盖小游戏、3D 建模这些场景。配套还优化了 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 的适配,Harness 要升到 0.2.1-rc.1 以上。
我对“许愿式编程”这四个字一直有点警惕。demo 能跑和项目能用,中间隔着依赖管理、错误处理、边界条件、可维护性。模型能在几分钟里给你一个贪吃蛇,这不难;难的是让它给你一个三个月后还能改的贪吃蛇。榜单上的分数涨 2 分,跟“能不能交付”是两件事。
不过有件事得承认:DeepSeek 这半年迭代的频率很吓人。V4.1 Flash 出来没多久就推 1017 版本,权重还照旧 MIT 开源,HuggingFace 和 ModelScope 都能下。对自建服务的人来说,这意味着可以拿最新权重跑在自己的卡上,不用等 API。
如果你在用 deepseek-flash,我的建议是别急着换工作流。先拿你手上真实的任务跑一遍,尤其是那种需要多轮改的长任务,看看输出是不是真的短了、对不对。官方的“帕累托改进”是在他们的评测集上成立的,你的场景里未必。省下来的 token 如果是靠少写注释、少写异常处理换来的,那省的不是钱,是以后的麻烦。